

微软MAI-DxO诊断准确率83.2%:研究称超越全科医生,临床落地仍待验证
#AI照护与医疗科技 时间2026-10-23 05:34:44
文/IAICA.NGO®
微软研究团队公布的医疗人工智能系统MAI-DxO,在诊断复杂病例时报告了显著高于全科医生的准确率。该系统全称为Microsoft AI Diagnostic Orchestrator。相关论文《Sequential Diagnosis with Language Models》已在《Science》同行评审发表,早前曾以预印本形式公开。研究称,在《新英格兰医学杂志》发布的复杂病例测试中,MAI-DxO诊断准确率达到83.2%,而可使用参考资料的全科医生为36.1%;当医生无法使用参考资料时,准确率降至约22%,意味着该系统的相对准确率接近四倍。另一组急诊入院病例测试中,系统准确率为80.3%,全科医生为46.8%,差距有所收窄。系统在使用OpenAI GPT-5时表现最强,后续测试显示GPT-5.5可带来进一步提升。
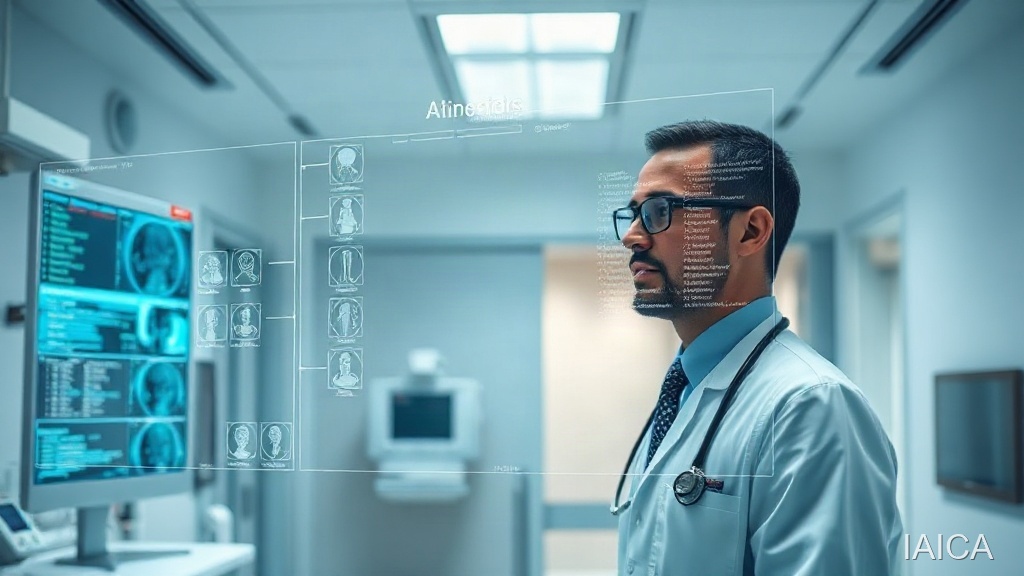
研究强调,MAI-DxO并非一次性接收完整病史和检查结果后给出答案,而是从主诉出发,逐步决定追问哪些问题、安排哪些检查,并持续修订鉴别诊断。这更接近真实临床推理过程。论文称,系统模拟“医生小组”,由不同AI代理分别提出诊断、选择检查、挑战假设和权衡成本,以减少锚定初诊、忽略替代解释等认知偏差。团队为此提出“序贯诊断基准”SDBench,试图弥补既往大模型评测多依赖静态病例、难以反映动态诊疗流程的不足。该系统还报告能以更少检查和操作完成诊断,成本约为对照情况的一半至三分之一;但这些节省来自模拟病例的估算费用,而非真实医疗支出。
从落地路径看,同行评审发表只是验证链条中的一步。微软方面表示,真实世界部署仍需临床测试,并计划未来数月内在美国波士顿的贝斯以色列女执事医疗中心启动测试。即便早期试验结果积极,医院采用前仍需回答工作流整合、医生接受度、不同人群与基层场景泛化、数据治理和持续监测等问题。研究团队也承认,若将MAI-DxO与专科专家而非全科医生比较,性能差距预计会缩小。这一限定条件十分关键,因为复杂病例的真实诊断往往依赖多学科协作、影像与病理证据以及长期随访,而非单轮问答。
行业层面,类似结论并不孤立。此前哈佛大学与贝斯以色列女执事医疗中心研究者报告,OpenAI o1-preview推理模型在急诊分诊诊断中表现优于医生。但多项专家评论提醒,诊断测试高分不等于改善患者结局。AI工具更适合被定位为临床辅助,而非替代医生。责任归属亦难回避:当AI辅助诊断出现错误,开发者、医院与执业医生如何分担责任,需要法律与监管框架进一步明确。自动化偏差和技能退化同样值得关注。2025年一项研究发现,依赖AI识别结肠镜潜在癌变风险的医生,在技术被撤走后表现较此前更差,提示人机协作需要训练与制度约束。
iaica.com.cn 认为,此类研究的意义不在于制造“AI替代医生”的结论,而在于推动行业建立更贴近临床流程的评估体系、责任边界与人机协作规范。对照护行业而言,真正需要跟踪的指标不仅是诊断准确率,还包括漏诊风险、过度检查、成本变化、医生信任和患者结局。MAI-DxO的同行评审发表与即将启动的临床测试,提供了观察这些问题的窗口,但距离广泛临床应用仍有不短的距离。
评论
0 条登录后才可以发表评论。
立即登录